Pochi istanti dopo il “Big Bang” dell’AI, il mercato dell’offerta è ancora in una fase simile a un plasma di quark e gluoni: i componenti fondamentali e i punti di controllo non si sono ancora stabilizzati in combinazioni durevoli. L’impresa ingegnerizzata non dovrebbe scommettere su quale configurazione prevarrà. Dovrebbe preservare una granularità sufficiente a separare i punti di controllo che contano e una modularità sufficiente a ricombinarli mentre il mercato prende forma.
A maggio ho sostenuto che “adozione dell’AI” è la cornice sbagliata per descrivere la trasformazione in corso. L’oggetto della strategia non è l’aggiornamento della cassetta degli attrezzi digitali, ma l’organizzazione dell’impresa: come si produce conoscenza, si coordina il lavoro, si prendono decisioni e si preserva il giudizio quando l’AI entra nell’architettura operativa dell’organizzazione.
Quattro mesi dopo, l’ambiente in cui l’impresa viene ingegnerizzata sta ancora prendendo forma: ecosistema dell’offerta AI, regolazione, geopolitica e struttura competitiva evolvono insieme. Quella che sembrava un’unica scelta strategica — quale modello o piattaforma mettere al centro dell’architettura AI? — comprende già almeno sei decisioni in parte interdipendenti: scelta dei modelli, controllo dei modelli adattati, infrastruttura di post-training, luogo dell’inferenza, routing e diritti sulle informazioni e meta-informazioni generate durante l’operatività. Questi punti di controllo si stanno già separando e ricombinando. Gli analisti distinguono ricavi da applicazioni, foundation model e inference hosting; per l’impresa ingegnerizzata la segmentazione è più fine. Oggi esistono almeno sei macro-categorie di decisioni strategiche interconnesse.
Sei decisioni nascoste dentro una sola scelta
| Macro-categoria decisionale | Che cosa si sta davvero scegliendo |
| Quali modelli e capacità? | API proprietarie, modelli open-weight, modelli specializzati o un portafoglio di modelli |
| Chi controlla il modello adattato? | Se pesi e checkpoint da fine-tuning o post-training restano vincolati al provider o possono essere controllati e spostati dal cliente |
| Chi fornisce l’infrastruttura di post-training? | Infrastruttura interna, servizi hyperscaler o piattaforme specializzate usate per adattare un modello esistente dopo il suo addestramento iniziale |
| Dove viene eseguita l’inferenza? | API del provider, hyperscaler, inference provider specializzato, private cloud, on-premise o self-hosted |
| Chi decide il routing di ogni richiesta? | Router interno, servizio di routing terzo o routing nativo del provider |
| Chi può usare le informazioni e meta-informazioni generate durante l’operatività, e per quale scopo? | Chi può osservare, conservare e usare prompt, output, correzioni, esiti, telemetria e stato intermedio generato dal modello e portato da una chiamata sequenziale alla successiva, per continuità o miglioramento |
Tabella 1. Sei decisioni nell’architettura AI dell’impresa.
La mappa è provvisoria: i confini si sposteranno mentre i fornitori si specializzano e ricombinano funzioni. Trattare le sei decisioni come un’unica scelta di vendor può trasferire senza accorgersene il controllo su disponibilità dei modelli, inferenza, fallback, flussi di dati e apprendimento. Una scorciatoia progettuale può diventare una debolezza architetturale.
La scelta dei modelli, l’infrastruttura e il serving estendono questioni familiari di cloud sourcing; custodia dei pesi adattati, routing in esecuzione e diritti sulle informazioni e meta-informazioni generate durante l’operatività sono punti di controllo meno familiari e sempre più contrattualizzabili separatamente. L’impresa può affittare il post-training trattenendo checkpoint o pesi e separare serving e routing: il primo stabilisce dove avviene il calcolo, il secondo quale modello o endpoint ammesso riceve la chiamata. La scelta del modello incide su capacità, licenze e switching; il serving su costo, latenza e residenza; il routing su fallback e performance comparata; post-training e checkpoint su adattamento e portabilità. Un solo accordo può ancora incorporare tutte e sei le decisioni.
Dalla classifica dei modelli alla mixture of models
Una classifica globale non basta: i modelli differiscono per capacità, costo, latenza e modalità di errore. Una mixture of models può instradare compiti diversi verso backend diversi invece di eleggere un modello a default universale.
Light Society lo fa tra LLM completi e surrogati distillati; il router di Cursor riporta che nessun modello domina tutte le categorie di lavoro sul codice. All’INSEAD AI Forum Europe, Theos Evgeniou ha formulato lo stesso problema: modelli diversi per compiti diversi, con il costo dei token gestito dinamicamente. La domanda diventa: quale modello deve svolgere questo compito, sotto questi vincoli?
Il routing crea anche una posizione informativa: chi lo gestisce osserva successi, fallimenti, fallback e correzioni comparate nei workflow reali — conoscenza che il singolo fornitore può non vedere e che invecchia quando cambiano modelli o interfacce. Il 19 agosto Stripe ha annunciato l’accordo per acquisire OpenRouter, un gateway che instrada e ottimizza l’uso dei token su oltre 400 modelli di più di 80 provider.
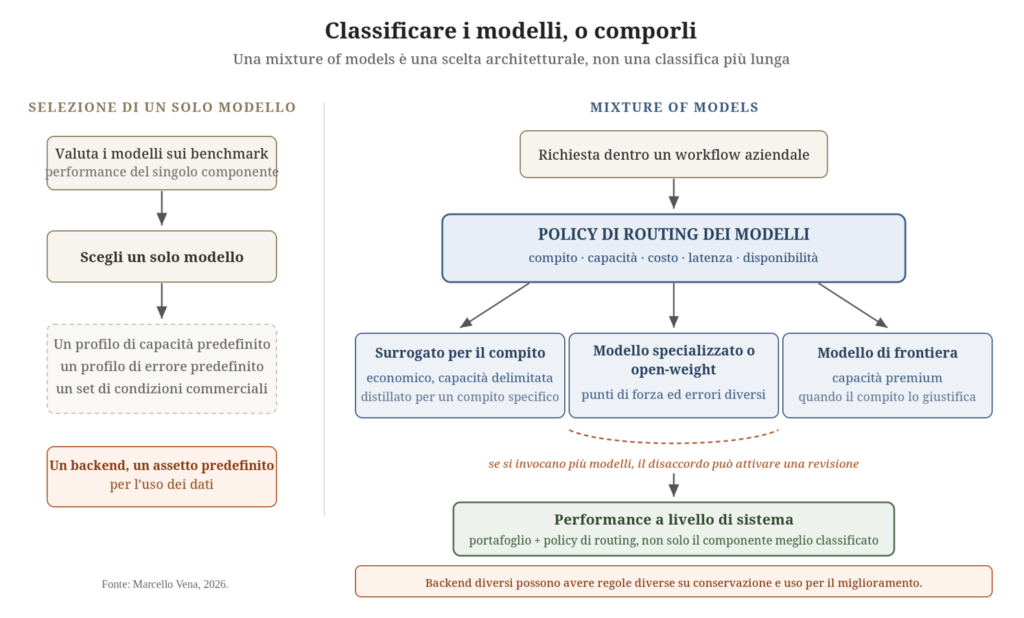
Figura 1. Classificare i modelli, o comporli. In un workflow aziendale, un approccio mixture of models può instradare le chiamate verso backend diversi. La performance dipende dal portafoglio e dalla policy di routing oltre che dai singoli modelli; anche le condizioni d’uso dei dati possono variare tra backend. Fonte: Marcello Vena, 2026.
I diritti strategici che poche imprese detengono
La sesta decisione riguarda le informazioni e meta-informazioni generate durante l’operatività: chi può osservarle, conservarle e usarle.
Un’interazione con l’AI produce sia un output immediato sia informazione su ciò che accade dopo — se viene accettato, corretto, rifiutato, ripetuto, escalato, eseguito o seguito da una decisione umana diversa. Hagiu e Wright chiamano il meccanismo più generale data-enabled learning: i prodotti possono migliorare grazie ai dati generati dai clienti, tra utenti diversi o nell’uso ripetuto dello stesso cliente. I workflow generativi e agentici arricchiscono questa traccia mostrando che cosa ha fallito e come è stato corretto.
Il confine contrattuale è più granulare di un generico “diritto ad apprendere”: osservazione, conservazione e uso per migliorare modelli o servizi sono permessi distinti. I sistemi agentici generano inoltre stato intermedio portato tra chiamate sequenziali, parte del quale può restare opaca o vincolata al provider.
La maggior parte delle prime cinque decisioni può, a un certo costo, essere rivista sostituendo o ricreando altrove le capacità necessarie. L’informazione già assorbita da un’altra organizzazione non può essere richiamata indietro nello stesso modo. Nei workflow con stato, la libertà di routing può inoltre restringersi prima della fine del compito: chi controlla lo stato intermedio determina in parte chi può instradare la chiamata successiva.
Che cosa mostrano Cursor e Windsurf
Cursor e Windsurf mostrano quanto il mercato dell’offerta sia ancora instabile. Entrambe sono nate come ambienti di coding AI che organizzavano il workflow dello sviluppatore attorno a frontier model forniti da altri. Cursor ha poi risalito lo stack: nel 2026 aveva sviluppato modelli Composer, sviluppato congiuntamente modelli Grok con SpaceXAI e costruito un router. Ha anche dichiarato di aver usato migliaia di miliardi di token di dati Cursor per addestrare uno di quei modelli, mentre il router inferisce la performance da ciò che l’utente fa subito dopo — ricombinando funzioni che il mercato stava separando.
Questa espansione non ha eliminato la dipendenza a monte. Dopo l’acquisizione di Cursor da parte di SpaceX, con un valore implicito dell’equity di 60 miliardi di dollari, OpenAI ha scelto di chiudere il contratto di fornitura. Windsurf aveva incontrato il problema prima: mentre OpenAI ne perseguiva l’acquisizione, Anthropic ridusse bruscamente l’accesso first-party a Claude; l’operazione poi fallì, seguita da un acqui-hire di Google e dall’acquisizione del business residuo da parte di Cognition. Quando il 3 settembre OpenAI ha rilasciato GPT-6 Astra, non lo ha reso disponibile attraverso il rapporto di fornitura con Cursor, mentre Cognition lo ha integrato in Devin il giorno stesso del lancio.
In entrambi i casi le decisioni dei fornitori hanno seguito la propria posizione strategica più che la domanda del cliente; la decisione di Anthropic, nella stessa settimana, di continuare a fornire Cursor dopo l’acquisizione da parte di SpaceX mostra lo stesso meccanismo con segno opposto. L’accesso ai modelli viene ancora trattato come strumento competitivo, non semplicemente come prodotto da vendere ovunque esista domanda.
Lo stack sta ancora prendendo forma
Man mano che queste decisioni diventano contrattualizzabili separatamente, emergono nuove posizioni di fornitura lungo lo stack AI. Alcune imprese si specializzano; altre si espandono su più funzioni e le ricombinano.
Thinking Machines è entrata dal post-training gestito con Tinker; River ha lanciato un’API per il training layer; Project Tapestry sviluppa un addestramento consortile distribuito per preservare il controllo locale dei dati e dei modelli derivati. Thinking Machines ha poi rilasciato Inkling, un modello multimodale open-weight personalizzabile su Tinker, passando dall’infrastruttura di post-training alla fornitura di modelli.
Alcune posizioni possono diventare infrastruttura per un mercato più ampio. Il 3 settembre Nvidia ha annunciato l’accordo per acquisire Hugging Face per 12,93 miliardi di dollari, ottenendo una piattaforma che combina già distribuzione di modelli, selezione degli inference provider, routing e fatturazione centralizzata. Nvidia afferma che Hugging Face resterà aperta a modelli, framework, cloud, provider di inferenza e piattaforme di calcolo diversi, senza richiedere capacità Nvidia — una posizione nell’ecosistema open-model senza legarla formalmente al proprio hardware. Non è una mossa isolata: Nvidia è investitore in Thinking Machines dal 2025 e, da marzo, partner di calcolo su scala gigawatt della società, la cui piattaforma Tinker monetizza il post-training di modelli open-weight sui dati proprietari dei clienti; secondo The Information, Nvidia è anche in trattative per entrare nel nuovo round di finanziamento. La strategia offre a Nvidia vantaggi sia dalla domanda di calcolo di frontier lab e hyperscaler sia dalla diffusione di open-weight model, private cloud e deployment locale, diversificando una base clienti concentrata in un numero relativamente ristretto di frontier lab e hyperscaler, alcuni dei quali, tra cui OpenAI e Anthropic, stanno iniziando a sviluppare silicio proprietario.
Che cosa chiede tutto questo all’impresa ingegnerizzata
L’instabilità dell’offerta rende centrale il bundling deliberato. La massima scomposizione trasferisce il costo di coordinamento all’impresa. L’integrazione ha valore, soprattutto per imprese più piccole che possono preferire un fornitore capace di assorbire integrazione e complessità operativa. Conta sapere quali decisioni sono raggruppate, chi le controlla e quale opzione si cede. Un test pratico è verificare se cambiare modello imponga di rinegoziare i diritti d’uso dei dati, rifare il post-training o riavviare il lavoro in corso.
L’orchestrazione opera a un livello diverso dal routing. Il routing sceglie il motore. L’orchestrazione esegue il lavoro. La gestione dello stato determina che cosa passa tra le chiamate. L’orchestrazione sequenzia compiti, strumenti e sistemi, retry, handoff e intervento umano. La gestione dello stato appartiene all’architettura dei workflow, non è una settima decisione lato offerta.
Elementi di questo disegno sono già visibili. All’INSEAD AI Forum Europe, Nicolai Tangen ha descritto Norges Bank Investment Management come combinazione di un piccolo team AI centrale, uso distribuito e modelli open source di backup; Hyunjin Kim ha inquadrato l’implementazione attraverso la funzione di produzione. Devigili e colleghi rilevano analogamente variazioni selettive nella domanda di competenze organizzative con l’aumento dell’esposizione alla GenAI.
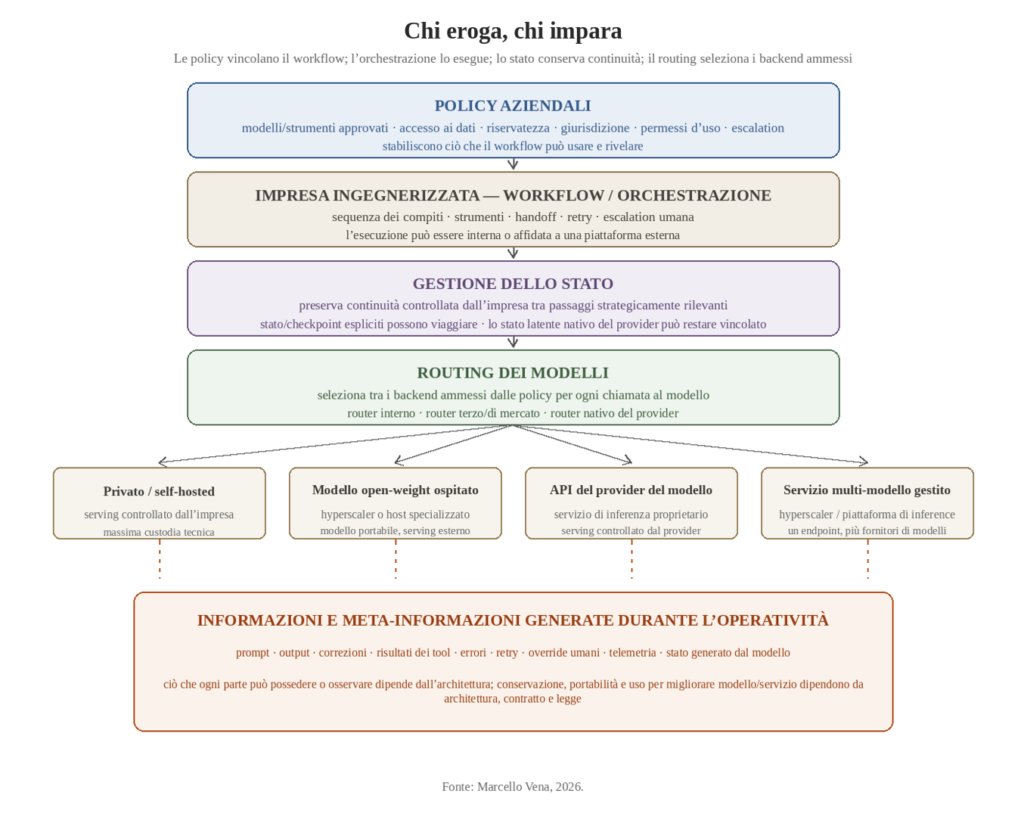
Figura 2. Chi eroga, chi impara. Le policy aziendali vincolano ciò che il workflow può usare e rivelare; l’orchestrazione esegue il lavoro tra modelli, strumenti, sistemi e persone; la gestione dello stato porta la continuità; il routing seleziona i backend ammessi. Le informazioni e meta-informazioni generate durante l’operatività possono emergere lungo tutto il workflow, mentre osservazione, conservazione, portabilità e uso dipendono da architettura, contratto e legge. Fonte: Marcello Vena, 2026.
L’impresa ingegnerizzata non è progettata per un particolare ecosistema dell’offerta. È progettata con intento strategico per adattarsi al mutare delle condizioni esterne, astraendo la complessità della propria architettura esterna di fornitura per le persone e i workflow che non devono gestirla direttamente.
La modularità — la capacità di cambiare componenti senza ricostruire l’intero sistema — assume qui uno scopo strategico più netto. Una modularità strategicamente utile dipende dalla granularità: l’architettura deve separare le decisioni al livello al quale l’impresa può avere bisogno di modificarle. Sostituire un modello restando vincolati su controllo dei pesi adattati, post-training, inferenza, routing o diritti sulle informazioni è modularità solo apparente. La flessibilità strategica richiede che quei punti di controllo possano essere ricombinati separatamente, permettendo all’impresa di rivedere ciò che integra o trattiene quando cambiano le condizioni, senza cedere ciò che la rende distinta.
Il valore dell’informazione dipende dall’architettura
La capacità di riconfigurarsi conta anche per un’altra ragione: l’informazione che l’impresa trattiene non ha un valore indipendente dall’architettura. Gli attuali sistemi centrati sugli LLM attribuiscono grande valore a testo, codice, segnali di preferenza e correzioni. Altre traiettorie enfatizzano stato, azione, traiettorie, interazione fisica e simulazione. All’INSEAD AI Forum Europe, Yann LeCun ha presentato i world model come una strada distinta verso sistemi che rappresentano e prevedono le conseguenze in modi diversi dagli LLM attuali.
Uno stock informativo può quindi restare accurato, proprietario e legalmente utilizzabile, ma diventare meno — o più — prezioso se cambia l’architettura capace di sfruttarlo. Lo stesso vale per la conoscenza che l’impresa accumula sui fornitori: valutazioni, regole di routing e profili di errore possono diventare obsoleti ancora più rapidamente quando i provider cambiano modelli o interfacce.
Siamo ancora ai primi istanti dopo il “Big Bang” degli LLM basati sui transformer. La strategia non può essere un esercizio una tantum di mappare l’ecosistema dell’offerta di oggi e irrigidire l’impresa attorno ad esso. L’impresa deve preservare la capacità di cambiare modelli, modalità di serving, router, workflow e scelte sull’uso dei dati quando esiste una ragione per farlo — sia che l’ecosistema dell’offerta continui a cambiare rapidamente, sia che prima o poi si stabilizzi.
Marcello Vena è Chief Strategy and Growth Officer Datrix Group.